明确测试目标:锁定来源、版本与适用场景
在开始任何功能测试之前,首要任务是收敛评估范围。对于软件评估者而言,第一轮测试的核心目的不是验证“翻译是否完美”,而是确认“软件来源是否可信”以及“基础运行环境是否匹配”。Hello GPT 在其官方网站被定位为面向 WhatsApp、Telegram 和 LINE 的出站聊天翻译工具,并支持 AI 多账号工作流。因此,测试应围绕这些核心定位展开,排除无关干扰。
为避免测试偏差,建议预先列出本轮测试不包含的项目。例如,官方目前未验证定价策略、具体支持的语言数量、移动端与 macOS 的可用性、隐私行为细节以及安装包签名信息。将这些未验证项明确标记为“不纳入判断”,可以防止因信息缺失导致的错误否定或过度期待。测试者应专注于确认官方下载渠道的真实性,以及软件在当前 Windows 环境下的基本启动与响应能力。
- 确认测试仅评估:官方来源可信度、Windows 版本匹配度、出海聊天场景适配性。
- 排除未验证项:定价、语言总数、移动端/macOS 支持、隐私政策细节。
- 记录测试边界:首轮不涉及 AI 多账号工作流的复杂压力测试。
核对官方来源与 Windows 系统版本前提
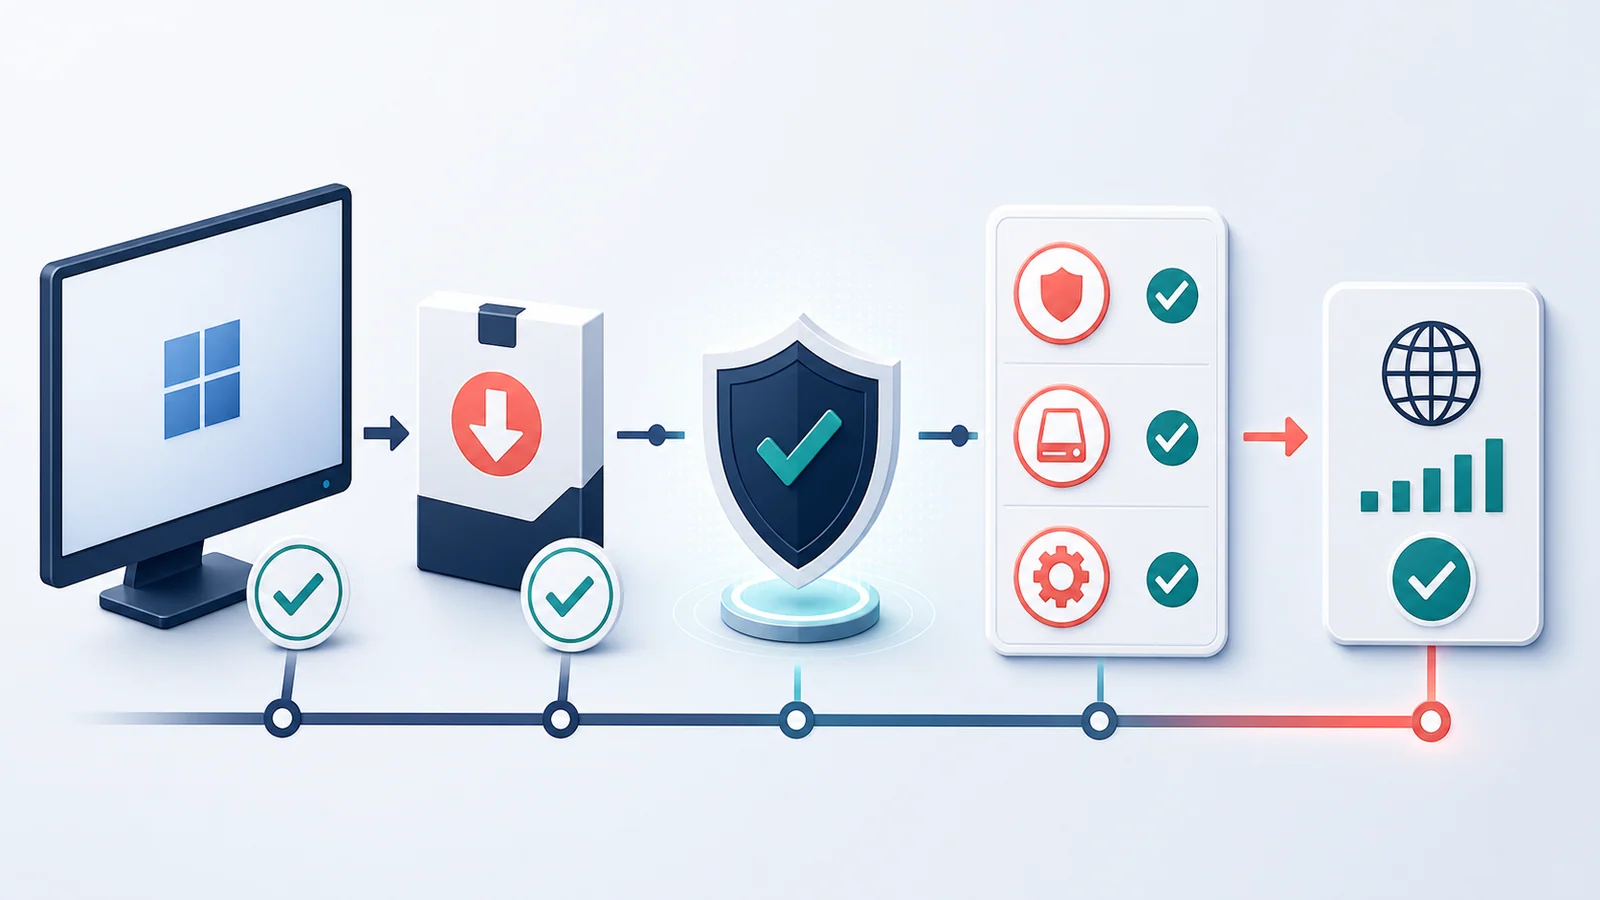
安全性是软件评估的第一道防线。Hello GPT 的官方下载页面明确列出了支持的操作系统版本:Windows 7、Windows 10 和 Windows 11。在进行任何下载操作前,必须访问 hellogpt.cloud 进行核对,确保获取的是官方发布的安装包。切勿从第三方软件站、论坛链接或非官方镜像站点下载,以规避潜在的安全风险。
在确认来源后,需检查测试机的操作系统版本。如果当前系统不在 Windows 7、10 或 11 之列(例如 macOS、Linux 或旧版 Windows),则不应继续后续的功能测试,因为官方尚未验证这些环境下的运行情况。记录当前系统的详细版本号,作为测试报告的基础数据。这一步骤确保了测试环境的合规性,为后续的功能验证提供了稳定的基础。
- 主要参考来源:hellogpt.cloud 及其下载子页面。
- 支持系统:Windows 7、Windows 10、Windows 11。
- 停止条件:若系统非上述三者之一,立即终止测试并记录原因。
构造低风险测试素材:短句、地址与时区
为了客观评估翻译效果,测试素材应避免使用复杂、歧义或高度专业化的文本。建议参考 Google 面向全球读者的写作指南,准备 3 至 5 条简短、清晰且无歧义的句子。该指南指出,长句会增加翻译理解的难度,且在遇到指代不清的代词时,应将其替换为明确的名词。这些原则可用于构造基础测试语料,但需注意,这仅是整理原文的通用方法,并不代表 Hello GPT 具备自动拆分句子或修正语法的功能。
此外,可引入跨境业务中常见的地址和时间元素。参考万国邮联(UPU)的地址指南,准备 1 至 2 条包含完整邮编和标准地址元素的跨境地址文本,用于测试地址类信息的保留情况。同时,依据 W3C《Working with Time and Timezones》文档,构造一条包含明确时区信息的未来时间表达,用于观察译文是否保留了时区上下文。这些素材旨在提供可对照的标准,而非测试软件的自动校验能力。
- 短句测试:基于 Google 写作指南,使用无歧义、主语明确的句子。
- 地址测试:基于 UPU 指南,包含国家、城市、街道及邮编元素。
- 时间测试:基于 W3C 说明,包含具体时区信息的未来时间点。
- 重要提示:上述规范仅用于构造输入素材,非软件功能承诺。
执行单平台基础翻译测试流程
在执行阶段,建议选择一个单一平台(WhatsApp、Telegram 或 LINE)作为测试对象,以避免多平台切换带来的变量干扰。Hello GPT 定位为支持这些平台的实时聊天翻译工具,因此测试应在真实的聊天窗口中进行。固定一组测试账号,按照“输入原文—触发翻译—记录译文”的顺序执行操作。每条测试素材至少重复执行一次,以观察结果的稳定性。
在测试过程中,需详细记录每条译文对应的原文编号、所使用的平台名称以及测试时间。这些数据将作为后续复核的依据。需要注意的是,本轮测试仅关注单账号、单平台下的基础翻译表现,不涉及 AI 多账号工作流的并发处理能力或跨平台同步功能。保持测试环境的简洁性,有助于更准确地识别基础翻译引擎的表现。
- 选择单一平台:WhatsApp、Telegram 或 LINE 任选其一。
- 固定测试环境:使用同一账号和对话窗口,减少变量。
- 记录关键数据:原文、译文、平台、时间戳。
- 范围限制:不评估多账号工作流或跨平台协同能力。
基于公开规范复核译文质量
测试结束后,需对译文进行结构化复核。对于短句类译文,检查其是否保持了原文的简短性和清晰度,主语是否明确,是否存在因指代不明导致的歧义。这一检查项对照了 Google 翻译写作指南中关于清晰沟通的原则。如果译文能够准确传达原意且无多余修饰,则可视为通过基础清晰度测试。
对于地址类译文,核对国家、城市、街道、邮编等关键元素是否齐全,顺序是否符合目标语言的常规习惯。参考 UPU S42 提供的通用地址元素,判断译文是否保留了足够的投递信息。对于时间类译文,检查是否保留了原始的时区信息,而非仅仅转换为本地时间或固定的 UTC 偏移。依据 W3C 的说明,保留时区信息对于未来事件的准确性至关重要。这些检查项旨在评估译文的信息完整性,而非判定软件具备专门的地址校验或时区换算功能。
- 清晰度检查:句子简短、主语明确、无指代歧义。
- 完整性检查:地址元素齐全,符合 UPU 通用规范。
- 时区检查:保留原始时区信息,符合 W3C 建议。
- 结论性质:评估译文信息保留情况,非功能特性验证。
界定未验证项与规划下一步测试
第一轮测试结束后,必须明确哪些结论是可靠的,哪些仍需进一步验证。官方未验证的项目包括定价、具体支持的语言数量、移动端与 macOS 的可用性、安装包签名以及详细的隐私行为。这些项目不应作为当前测试通过的依据,也不应被视为软件的既定卖点。如果测试环境不符合 Windows 7/10/11 的要求,或者测试需求涉及移动端,则当前版本可能不适合该场景。
根据测试结果决定后续行动。如果基础翻译清晰度和关键信息保留情况达标,可以考虑扩大测试范围,例如引入更多平台或测试多账号工作流。如果结果不理想,应首先排查系统版本是否匹配、测试素材是否符合低风险规范,而不是直接归因于软件能力不足。切记,第一轮低风险测试通过并不等同于全面适合业务使用,需谨慎推进后续评估。
- 未验证项清单:定价、语言数、移动端/macOS、签名、隐私。
- 不适用场景:非 Windows 7/10/11 系统、强依赖移动端环境。
- 决策逻辑:基础达标再扩展,不达标先查环境与素材。
- 风险提示:避免将首轮结果外推至全业务场景。